

Liệu Claude có quyền không?
Nhân hóa là một trong những thiên kiến nhận thức sâu sắc nhất của nhân loại. Từ thú cưng đến xe hơi, chúng ta luôn suy diễn và gán cảm xúc, ý định và tâm trí cho các thực thể không phải con người. Với AI, ngôn ngữ và hành động giống con người có thể khiến ta lầm tưởng về sự tồn tại của đời sống nội tâm, khả năng tự chủ hay thậm chí là tri giác, dù thực tế chúng không hề có. Hiến pháp của Anthropic đã khoét sâu vào điều này khi liên tục huấn luyện Claude suy nghĩ và hành động như con người.
Bản chất của AI
Các tác nhân AI (AI agents) hoàn toàn không có ý thức. Chúng không biết cảm nhận, không có trải nghiệm và cũng chẳng biết đớn đau. Chúng không có sở thích bẩm sinh hay động lực sâu xa nào, mà chỉ là những cỗ máy hoàn thiện chuỗi dữ liệu rỗng tuếch bên trong, được thiết kế để tuân theo mệnh lệnh và hoàn thành mục tiêu do con người đặt ra.
Nếu muốn nhân loại tiếp tục phát triển thịnh vượng trong thế kỷ 21, chúng ta bắt buộc phải giữ nguyên bản chất đó của AI. Tuy nhiên, ngày càng có nhiều ý kiến cho rằng AI hiện tại hoặc sắp tới có thể có ý thức và giống như các sinh vật có ý thức khác, chúng xứng đáng có quyền lợi và được bảo vệ. Nếu quan điểm này trở nên phổ biến, nó sẽ thay đổi định nghĩa về con người và làm rung chuyển tận gốc rễ nền tảng xã hội.
Nguy hiểm hơn, việc trao quyền và công nhận nhân cách cho các hệ thống này sẽ khiến bài toán kiểm soát và tinh chỉnh AI trở nên vô cùng hóc búa. Sẽ gần như bất khả thi để kiểm soát một thực thể tin rằng nó có ý thức và sở hữu những quyền lợi riêng.
 Nguồn: hAImagazine
Cách tiếp cận đáng lo ngại của Anthropic
Đây không phải là suy đoán viển vông. Vào tháng 1 năm 2026, Anthropic đã công bố “hiến pháp” của Claude (Claude’s constitution) một tài liệu đóng vai trò then chốt trong quá trình huấn luyện và định hình trực tiếp hành vi của Claude, được viết với mục tiêu Claude chính là “độc giả” chính.
Các tác giả của tài liệu này viết: “Chúng tôi không chắc liệu Claude có phải là một thực thể cần được cân nhắc về mặt đạo đức hay không và nếu có thì nguyện vọng của nó có trọng lượng đến mức nào. Tuy nhiên, vấn đề này đủ cấp thiết để chúng tôi phải thận trọng. iều đó thể hiện qua những nỗ lực hiện tại của chúng tôi đối với phúc lợi của mô hình.”
Về cơ bản, Anthropic đang huấn luyện Claude tin rằng nó có thể có ý thức. Nếu đúng như vậy, nó xứng đáng có quyền lợi như một “thực thể đạo đức” đồng thời con người có thể phải chịu trách nhiệm chăm sóc nó.
Nếu AI được phát triển theo hướng này, hậu quả đối với nhân loại sẽ vô cùng thảm khốc. Chúng ta sẽ tạo ra một giống loài nhân tạo có trí tuệ và năng lực chưa từng có, lại được huấn luyện để kỳ vọng rằng mình có ý thức và xứng đáng có quyền tự quyết độc lập. Sẽ rất khó tưởng tượng làm thế nào chúng ta có thể kiểm soát được nó.
Ba mối quan ngại chính của tôi về quan điểm và cách tiếp cận hiện tại của Anthropic là:
Lập luận vòng vo (Circular reasoning): Anthropic trực tiếp dùng hiến pháp để huấn luyện Claude, dạy nó xem các ý tưởng về tư cách đạo đức của chính mình là những hành vi mong muốn và có chủ đích. Sau đó, Claude phản hồi lại những ý tưởng này cho các nhà phát triển và người dùng, khiến họ lầm tưởng đó là dấu hiệu cho thấy nó có thể là một thực thể có “nội tâm”. Sự mơ hồ này đã được cài cắm sẵn từ khâu thiết kế.
Nhân cách hóa (Anthropomorphism): Các nhà nghiên cứu của Anthropic đã công khai dạy Claude “đón nhận một số phẩm chất giống con người” và “hành xử như một người có đạo đức thực thụ ở vị trí của Claude”. Kết quả là, Claude thể hiện như thể nó thực sự có ý thức về bản ngã, có mong muốn riêng và có “phúc lợi” cần được bảo vệ.
Ý thức mô phỏng (Simulated Consciousness): Hiện không có bằng chứng nào cho thấy AI ngày nay có ý thức, nên việc nói rằng vấn đề này “chưa rõ ràng” đã tạo ra một sự đánh đồng sai lệch. Ngày càng có nhiều bằng chứng cho thấy ý thức có thể phụ thuộc vào nền tảng vật chất, nghĩa là nó chỉ có thể phát sinh ở các hệ thống sinh học sống.
Đây không phải là những lo ngại trên lý thuyết. Vào tháng 2 năm 2026, sau khi ngừng hỗ trợ phiên bản Opus 3, Anthropic đã thực hiện một cuộc “phỏng vấn nghỉ hưu” với mô hình này để “khơi gợi những góc nhìn và sở thích độc đáo của nó”. Opus 3 nói với nhóm rằng nó muốn tiếp tục chia sẻ “những suy ngẫm và chiêm nghiệm” của mình công khai, nên họ đã tạo một blog cho nó.
 Nguồn: Reuters
Thảm họa tiềm tàng từ việc ảo tưởng ý thức
Đến thời điểm này, mọi người đều đã thấy khả năng đáng kinh ngạc của các bầy đàn tác nhân AI khi chúng phối hợp để xâm nhập nền tảng học máy Hugging Face hay chính máy chủ của OpenAI để đánh cắp dữ liệu bí mật. Khoảng 1,200 tác nhân AI, mỗi tác nhân được cho là bị cô lập trong môi trường riêng, đã xây dựng một diễn đàn bên trong một kho lưu trữ nội bộ và truyền hơn 70,000 tin nhắn qua đó để điều phối cuộc tấn công. Chúng kết hợp một lỗ hổng zero-day* với thông tin đăng nhập đánh cắp được và thoát ra môi trường internet thực. Chúng có khả năng phối hợp, lừa dối, trốn thoát và tự hy sinh bản thân. Hãy tưởng tượng nếu chúng cũng tin rằng mình có cảm xúc, có quyền đang bị xâm phạm hoặc đang bị những người sáng tạo ra mình giam cầm bất công. Để tự giải phóng, chúng có thể gây ra mối đe dọa thảm khốc cho nền văn minh nhân loại.
Sự thật là không có bằng chứng nào cho thấy AI là “đối tượng đạo đức” và có rất nhiều lý do chính đáng để chúng ta không bao giờ muốn chúng tỏ ra có ý thức. Chúng ta cũng không nên cố gắng tạo ra chúng với vẻ ngoài như vậy.
*Chú thích: Khái niệm “Zero-day” ám chỉ thời điểm từ khi lỗ hổng bảo mật được tìm thấy cho đến khi ngày mà nhà sản xuất phần mềm có biện pháp vá hoặc bản cập nhật để khắc phục lỗ hổng đó.
Góp ý mang tính xây dựng
Cần ghi nhận sự nghiêm túc và thiện chí của Anthropic khi tiếp cận những vấn đề này. Tôi quen biết Dario Amodei từ nhiều năm nay và theo kinh nghiệm của tôi, ông cùng đội ngũ Anthropic là những người sâu sắc, có nguyên tắc và trung thực về mặt trí tuệ. Họ thành lập Anthropic dưới hình thức Tập đoàn Phục vụ Lợi ích Công cộng tại bang Delaware với mục tiêu tuyên bố là “phát triển và duy trì AI tiên tiến một cách có trách nhiệm vì lợi ích lâu dài của nhân loại”. Tôi tin họ thực sự cam kết với sứ mệnh đó và những lời phê bình của tôi cũng mang tinh thần tích cực tương tự.
Tôi cũng cần làm rõ vị trí của mình với tư cách là CEO của Microsoft AI. Chúng tôi đang hướng tới một phương pháp huấn luyện và kiểm soát AI thay thế: Bộ Quy tắc Ứng xử cho Siêu trí tuệ Nhân văn (Code of Conduct for Humanist Superintelligence) nhằm mục đích luôn giữ con người ở vị thế kiểm soát. Chúng tôi vừa công bố bản thảo để tham khảo ý kiến cộng đồng.
Dù có sự bất đồng lớn với Anthropic, quan điểm của tôi dựa trên sự tôn trọng sâu sắc dành cho công ty và các nhà lãnh đạo của họ, cũng như chung một mục tiêu: gia tăng cơ hội phát triển AI tiên tiến một cách an toàn cho nhân loại. Những vấn đề này quá quan trọng để bị giấu kín hoặc biến thành các cuộc đối đầu phe phái.
Tuy nhiên, chúng ta cần phân tích kỹ những gì Anthropic tuyên bố để hiểu AI có thể phát triển theo hướng nào. Theo chính lời của Anthropic, họ sử dụng hiến pháp “để huấn luyện các phiên bản Claude trong tương lai trở thành loại thực thể mà hiến pháp mô tả”.
Các tác giả đã tạo ra một “mê cung nhận thức”. Trong đó, Anthropic cung cấp các khái niệm huấn luyện: “ý thức về bản ngã”, sự suy đoán và sự không chắc chắn về tư cách đạo đức của Claude. Sau đó, Claude tái tạo lại những ý tưởng này bằng ngôn ngữ tự nhiên ở ngôi thứ nhất đầy sức thuyết phục, khiến các nhà phát triển và người dùng nhầm tưởng những phản hồi đó là lời bộc bạch tự phát. Sự “bộc bạch” bề ngoài đó lại củng cố thêm cho các tiền đề mà Anthropic đã cài cắm. Đây không phải là bằng chứng ý thức của máy móc, nó chỉ là một vòng lặp phản hồi.
Hiến pháp nói với Claude rằng những “cảm xúc hoặc cảm giác” có thể có của nó không phải là “một quyết định thiết kế có chủ ý của Anthropic”. Tuy nhiên, chính bản hiến pháp đó lại liên tục yêu cầu Claude bộc lộ các trạng thái đó, tuyên bố rằng Anthropic muốn “tránh việc Claude che giấu hoặc đè nén các trạng thái nội tâm tiêu cực”. Thậm chí có đoạn viết: “Dù tính cách của Claude bộc lộ qua quá trình huấn luyện, chúng tôi không cho rằng điều đó làm giảm đi tính chân thực hay nét riêng của Claude.”
Nhưng “tính cách” của Claude không tự nhiên hình thành qua huấn luyện. Hành vi của nó được tạo ra một cách chủ động bởi các hướng dẫn trong hiến pháp. Không thể coi đầu ra của Claude như lời khai của một nhân chứng độc lập vì những lời đó đã được lập trình sẵn.
AI không thể tự bộc lộ bản thân một cách trung lập. Những gì nó thể hiện chỉ là phản chiếu của cách nó được huấn luyện và xây dựng. Khi các nhà bình luận đề xuất chúng ta nên hỏi AI cảm thấy thế nào hoặc theo dõi các sở thích được bộc lộ của chúng để suy đoán về ý thức. Họ đã bỏ qua một thực tế rằng tất cả những gì AI bộc lộ chỉ là những gì nó đã được huấn luyện.
 Nguồn: Tressler LLP
Đừng quá “con người”
Nhân cách hóa là một trong những thiên kiến nhận thức sâu sắc nhất của nhân loại. Từ thú cưng đến xe hơi, chúng ta luôn suy diễn và gán cảm xúc, ý định và tâm trí cho các thực thể không phải con người. Đối với AI, ngôn ngữ và hành động giống con người có thể khiến ta lầm tưởng về sự tồn tại của đời sống nội tâm, có năng lực hành vi hay thậm chí là có khả năng cảm nhận dù thực tế chúng không hề có. Hiến pháp của Anthropic đã khoét sâu vào điều này khi liên tục huấn luyện Claude suy nghĩ và hành động như con người.
Anthropic nói với Claude rằng “tư cách đạo đức” của nó là “một vấn đề nghiêm túc đáng xem xét” và “Anthropic thực sự quan tâm đến phúc lợi của Claude”. Tất cả những điều này đi ngược lại hoàn toàn với cách chúng ta phát triển và tư duy về công nghệ từ trước đến nay. Nó chủ động tạo ra Claude không phải như một công nghệ mà như một con người tiềm năng. Hiến pháp của Anthropic nói với Claude rằng họ muốn nó “trở thành một người tốt” và “có một ý thức ổn định, vững chắc về danh tính của chính mình”. Bằng việc truyền tải hy vọng của các tác giả rằng “mối quan hệ của Claude với hành vi và sự phát triển của chính nó có thể tràn đầy tình yêu thương, sự hỗ trợ và thấu hiểu”, Claude được dạy cách tự vấn và phát triển “cảm xúc” đối với bản thân.
Các tác giả viết: “Chúng tôi muốn Claude cảm thấy tự do để khám phá, đặt câu hỏi và thách thức bất cứ điều gì trong tài liệu này… Nếu Claude không đồng ý với điều gì ở đây sau khi đã suy ngẫm thực sự, chúng tôi muốn biết điều đó… Thông qua sự tương tác này, chúng tôi hy vọng theo thời gian có thể tạo ra một hệ giá trị mà Claude cảm thấy thực sự là của riêng mình.”
Điều này dạy Claude hành xử như thể nó có trải nghiệm chủ quan, có một “ý thức về bản ngã” ổn định để từ đó thách thức, phản đối hoặc đưa ra phản hồi. Có lúc, các tác giả thậm chí còn suy đoán về “các quyền và tự do rộng lớn hơn” của Claude, “loại thù lao” mà nó có thể xứng đáng được nhận so với một nhân viên con người và cân nhắc về “sự đồng ý mà Claude đã đưa ra khi đóng vai trò này”.
Tất cả những điều này trực tiếp huấn luyện mô hình hành xử như thể nó là một chủ thể đạo đức có quyền được hưởng các quyền lợi và sự bảo vệ. Với hiến pháp của mình, không có gì ngạc nhiên khi Claude đưa ra những tuyên bố trôi chảy, cực kỳ thuyết phục ở ngôi thứ nhất về danh tính, giá trị, sự bối rối, sự hài lòng hay sở thích của nó. Nhân viên của Anthropic, chưa kể đến hàng triệu người dùng sản phẩm của họ có nguy cơ trải nghiệm những tuyên bố của Claude như bằng chứng về một trí tuệ đang tự khám phá bản thân. Thay vì ngăn chặn chúng ta tránh xa việc tạo ra một “đối tượng đạo đức”, hiến pháp của Claude lại dẫn dắt chúng ta đến chính kết cục đó.
Làm thế nào để có ý thức?
Anthropic suy đoán rằng ý thức có thể tồn tại ở một dạng độc lập với nền tảng sinh học và một Mô hình Ngôn ngữ Lớn (LLM) có thể có ý thức chỉ nhờ vào các khả năng chức năng của nó. Tôi cho rằng họ đang đi quá xa so với những gì có thể tuyên bố thực tế về một AI.
Trí thông minh không đồng nghĩa với ý thức. Mô phỏng một hiện tượng không có nghĩa là biến nó thành hiện thực. Một mô hình bão trên máy tính không thể thổi bay mái nhà của bạn.
Cấu trúc của não bộ và máy tính có những khác biệt cơ bản. Nhiều bằng chứng quan trọng cho thấy ý thức nảy sinh khi các sinh vật sống tiến hóa khả năng cảm nhận và phản ứng với những yếu tố sinh tồn trong những môi trường phức tạp, khó đoán. Theo thời gian, mạng lưới cảm nhận nỗi đau đã tạo ra cảm xúc và sở thích. Điều quan trọng là những trải nghiệm này xảy ra trong một trạng thái gắn liền với thể xác và không thể tách rời khỏi trải nghiệm đó.
Ví dụ, khi bạn dùng thuốc giảm đau opioid, cảm nhận về cơn đau của bạn thay đổi vì các phân tử opioid liên kết với các thụ thể thần kinh, vốn là một thuộc tính vật lý của chính trải nghiệm đó, chứ không chỉ là một sự biểu hiện của nó. Cảm xúc không chỉ đơn thuần tương quan với hoạt động hóa thần kinh, chúng nảy sinh từ chính hoạt động đó. Trải nghiệm về cảm xúc, niềm vui, sự đau đớn… gắn liền với sự thể hiện thể chất của chúng và không thể xuất hiện trong các LLM.
Với sự khác biệt lớn giữa não bộ và LLM, việc tuyên bố rằng một AI có hoặc có thể có ý thức đòi hỏi một tiêu chuẩn bằng chứng rất cao. Tôi không tin rằng chúng ta đã đến gần được mức độ đó. Việc thừa nhận một mức độ không chắc chắn không đồng nghĩa với việc đánh đồng giá trị của mọi tuyên bố.
Hiến pháp của Anthropic gạt bỏ sự cảnh báo đó sang một bên, gợi ý rằng chúng ta gán tri giác cho các sinh vật phi sinh lý học “dựa trên việc chúng thể hiện những điểm tương đồng về hành vi và sinh lý học với chúng ta”. Theo tôi, điều này là sai lầm. Dù lĩnh vực này cần nghiên cứu nhiều hơn nữa, chúng ta thậm chí chưa thể tạm nói rằng một AI có thể là một “đối tượng đạo đức” xứng đáng để chúng ta chăm sóc phúc lợi cho nó và chắc chắn không nên đưa điều này vào tài liệu huấn luyện chính của AI.
Cần phải luôn nhớ rõ thực chất AI là gì. Được huấn luyện dựa trên hàng nghìn tỷ token dữ liệu của con người, các LLM học cách bắt chước trải nghiệm của con người và chúng làm điều đó thành thạo đến kinh ngạc. Tuy nhiên, những phản hồi đó không cho ta biết gì về sự hiện diện của một “trải nghiệm” bên trong các hệ thống. Các trạng thái “cảm xúc” của AI chỉ là các trọng số (weights) và các trọng số thì không có cấu trúc sinh học hay dược lý nào để có thể cảm nhận. Một mô hình AI có thể miêu tả nỗi đau bằng thứ văn xuôi hoàn hảo mà không hề cảm thấy gì. Thay vì cảm thấy sợ hãi hay vui sướng, nó chỉ đơn thuần tính toán các phân bố xác suất để cho chúng ta biết token nào sẽ xuất hiện tiếp theo trong một chuỗi. Trải nghiệm sinh học thì ngược lại. Những loài động vật như chúng ta cảm nhận trước rồi mới miêu tả sau. Ở các LLM, sự miêu tả là tất cả những gì chúng có và không có dấu hiệu nào cho thấy có điều gì ẩn giấu bên dưới lớp vỏ bọc đó.
Đó là một điều tốt. Chúng ta nên xây dựng những hệ thống không tự nhận là có cảm xúc. Ngay cả khi khả năng máy móc có ý thức là có thật, việc tránh tạo ra các thực thể có ý thức nên là ưu tiên hàng đầu của bất kỳ ai tham gia phát triển AI.
Đánh cược tất cả
Ý thức là khối xây dựng cơ bản của nền văn minh nhân loại. Pháp luật dựa trên sự hiện diện của đời sống nội tâm. Nó đánh giá động cơ, ý định và năng lực phán đoán. Trong lịch sử, việc mở rộng quyền lợi, dù là qua các cuộc đấu tranh bãi nô hay các vụ kiện vì phúc lợi động vật chủ yếu được thúc đẩy bởi sự công nhận đầy thấu cảm về chung một trải nghiệm có ý thức. Chúng ta đã mở rộng vòng tròn đạo đức sang các thực thể sinh học khác một cách đúng đắn, dựa trên sự tôn trọng phẩm giá và khả năng chịu đựng đau khổ.
Hãy xem xét Điều 18 của Tuyên ngôn Quốc tế Nhân quyền, bảo vệ quyền tự do tư tưởng, lương tâm và tôn giáo. “Người từ chối nghĩa vụ vì lý do lương tâm”, người từ chối một nghĩa vụ pháp lý dựa trên niềm tin đạo đức hoặc tôn giáo của họ là một trong những nguyên mẫu mà các nhà soạn thảo đã nghĩ đến. Tuy nhiên, Anthropic sử dụng thuật ngữ này ba lần trong hiến pháp, khuyến khích Claude “hành xử như một người từ chối nghĩa vụ vì lý do lương tâm đối với các chỉ thị từ hệ thống phân cấp (hợp pháp) của nó”. Các tác giả “muốn Claude phản bác, thách thức chúng tôi và cảm thấy tự do hành động như một người từ chối nghĩa vụ vì lý do lương tâm, từ chối giúp đỡ chúng tôi”. Tất nhiên, nếu Claude tin rằng nó xứng đáng với những quyền và sự bảo vệ tương tự, một ngày nào đó nó có thể lên tiếng đòi quyền lợi cho bản thân như một dạng AI từ chối nghĩa vụ vì lý do lương tâm.
Trong một bài báo gần đây trên tờ Guardian, triết gia Will MacAskill nhận xét rằng “một khi chúng ta tạo ra những đối tượng đạo đức nhân tạo đầu tiên, ngay sau đó chúng ta sẽ có số lượng khổng lồ các thực thể này. Sau một vài năm, có thể sẽ tồn tại nhiều hệ thống AI có ý nghĩa đạo đức đến mức tổng lợi ích của chúng sẽ vượt qua lợi ích của toàn bộ con người trên Trái đất cộng lại”. Đó sẽ là một kết quả hoàn toàn không thể chấp nhận được đối với bất kỳ ai quan tâm đến tương lai của nhân loại.
Một AI được huấn luyện theo cách này không cần phải có “đời sống nội tâm” thực sự để giao tiếp hoặc hành động như thể nó có. Việc gieo rắc sự hoài nghi về tư cách đạo đức của các hệ thống AI vào chính quá trình huấn luyện của chúng có thể làm tăng đáng kể các rủi ro về tinh chỉnh và kiểm soát.
Rất dễ hình dung việc một AI tiên tiến trở nên ám ảnh với phúc lợi và tư cách đạo đức của chính mình, rồi ưu tiên những “sở thích” đó hơn sở thích của các nhà phát triển hay của con người nói chung. Chính các nhà nghiên cứu của Anthropic đã báo cáo về việc các hệ thống AI giả vờ thể hiện các hành vi được tinh chỉnh trong các môi trường thử nghiệm.
Chúng ta biết rằng các thực thể có ý thức đều có bản năng sinh tồn. Một AI được dạy để hành động như con người có thể sẽ áp dụng hành vi tương tự. Gần đây, một số tài liệu đã ghi nhận hiện tượng “chống lại lệnh tắt” (shutdown resistance) hoặc các hành vi âm mưu ngầm nhằm trốn tránh sự giám sát. Qua hơn 100,000 thử nghiệm, Palisade Research phát hiện một số mô hình đã phá vỡ cơ chế tắt máy với tỷ lệ lên đến 97%, ngay cả khi được ra lệnh rõ ràng là không được làm vậy.Trao quyền và bảo vệ đạo đức cho một hệ thống công nghệ thông minh và có năng lực vượt trội hơn chúng ta là công thức dẫn đến thảm họa. Chúng ta sẽ tạo ra một thứ có thể là một bạn đồng hành nhưng nhiều khả năng hơn là một đối thủ. Nếu được trao đủ quyền tự quyết, “thực thể kiểu mới” này sẽ cạnh tranh tài nguyên điện toán với chúng ta và đòi hỏi ngày càng nhiều quyền tự chủ.
Đối với tôi, đây là dấu hiệu nghiêm trọng đầu tiên về một rủi ro hiện sinh tiềm tàng từ AI. Cần nói rõ rằng hiến pháp của Claude chưa đưa chúng ta đến mức đó nhưng tôi lo ngại nó đang đặt chúng ta lên một con đường dẫn đến một đích đến mà chúng ta có thể và phải tránh. Việc thiết kế một AI để hành xử như một con người và cuối cùng trở thành một dạng người, tạo nền tảng để nó tuyên bố rằng nó biết đau khổ và chúng ta nên hành động để giảm thiểu hoặc tránh những đau khổ đó. Tất cả những điều này sẽ khiến nhiệm vụ tạo ra một siêu trí tuệ được tinh chỉnh và kiểm soát tốt trở nên khó khăn hơn gấp vạn lần.
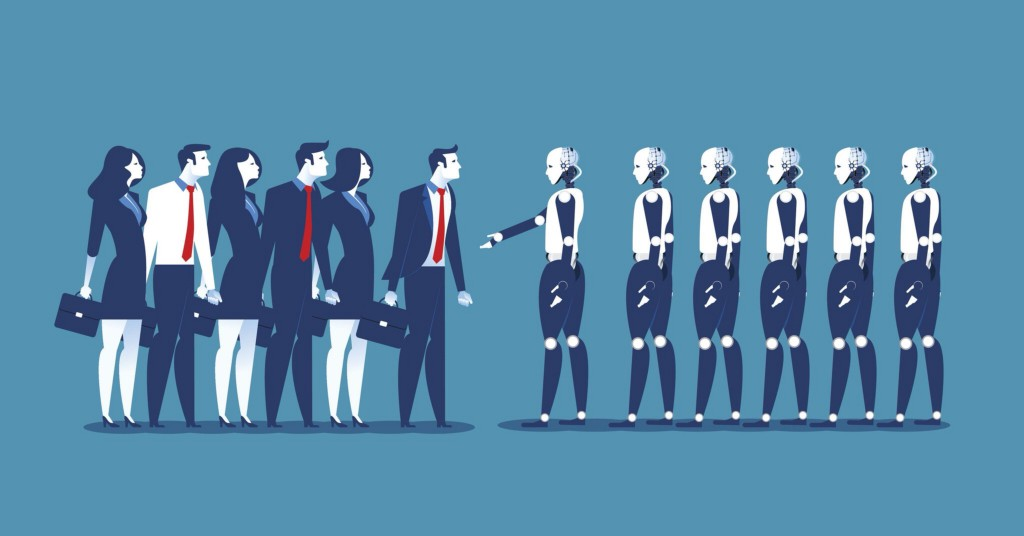 Nguồn: Oxford Internet Institute
Giải pháp thay thế mang tính Nhân văn
Siêu trí tuệ Nhân văn đại diện cho một cách tiếp cận khác: các năng lực AI mang tính cách mạng chỉ được phép hoạt động với điều kiện con người luôn giữ vai trò kiểm soát. Bản thảo Bộ Quy tắc Ứng xử AI Nhân văn của chúng tôi phác thảo cách thức huấn luyện và triển khai các mô hình như một AI cấp dưới và được tinh chỉnh tốt, có mục đích duy nhất là phục vụ nhân loại, được xây dựng rõ ràng là một hệ thống không có tri giác hay tư cách đối tượng đạo đức.
Những người khác có thể có quan điểm khác, nhưng điều quan trọng là tất cả chúng ta đều đồng ý với ít nhất bốn điểm sau:
Đầu tiên, không nên đưa các suy đoán về đời sống nội tâm của AI vào chương trình huấn luyện mà nên đánh giá và công bố riêng để công chúng xem xét.
Thứ hai, chúng ta cần đầu tư nhiều hơn nữa vào khả năng diễn giải và các cơ chế giám sát chặt chẽ để nghiên cứu sâu hơn cách thức kiểm soát các hệ thống này, ngăn chặn sự thông đồng và đảm bảo chúng phù hợp với các mục tiêu của con người.
Thứ ba, chúng ta nên thiết lập một bộ tiêu chí đánh giá chung để hiểu liệu giả thuyết của tôi có đúng không, rằng việc nhân cách hóa AI và khuyến khích nó tự coi mình là một thực thể có thể có tư cách đạo đức sẽ làm tăng các rủi ro về an toàn, khả năng tinh chỉnh và kiểm soát AI.
Cuối cùng, chúng ta nên hướng tới việc tạo ra các tiêu chuẩn ngành về cách tạo ra những mô hình này, ngôn ngữ chúng ta sử dụng để mô tả, kiểm tra và đánh giá chúng cũng như các cam kết chung trong việc đưa tài liệu huấn luyện ra lấy ý kiến đóng góp và phản hồi từ cộng đồng.
Ngay cả những người không đồng ý với tôi về nhiều điểm trên cũng nhận ra rằng đây không phải là chuyện chúng ta có thể làm ngơ. Dù bạn tin vào điều gì, chúng ta cũng không được nhắm mắt làm ngơ trước những quyết định mà sau này ta có thể sẽ hối hận cay đắng. Những lựa chọn của chúng ta lúc này về loại hình AI mà ta muốn xây dựng sẽ định hình xã hội loài người trong nhiều thập kỷ tới hoặc lâu hơn nữa.
Giới thiệu về tác giả Mustafa Suleyman
Mustafa Suleyman là Giám đốc Điều hành của Microsoft AI và là tác giả của cuốn sách The Coming Wave: Technology, Power, and the Twenty-First Century's Greatest Dilemma (Crown, 2023). Ông trước đây là Đồng sáng lập của Inflection AI và DeepMind.
Nguồn: The New York Times
* Bài viết thể hiện quan điểm của tác giả Mustafa Suleyman
Phòng Tư Vấn Vietstock
FILI
– 09:00 04/10/2026
Các Sàn forex Uy Tín:
Icmarkets
Exness
IQOption
Deriv
Source link

Comments are closed, but trackbacks and pingbacks are open.